Backups : sauvegarder et restaurer vos données
Point de théorie · à lire avant que votre application ne contienne des données auxquelles vous tenez
Slides du cours
Le chapitre sur l'hébergement citait les sauvegardes dans une seule ligne de tableau : « une mauvaise commande, et sept semaines de données sont perdues ». Ce chapitre développe cette ligne. Il explique les principes, présente les outils par stack et par hébergeur, et renvoie à leur documentation officielle. Dans les parties 6 et 7, lisez ce qui correspond à votre projet.
À la fin de ce chapitre, vous serez capables de :
- lister ce qui doit être sauvegardé dans une application web, et ce qui ne doit pas l'être ;
- expliquer la règle 3-2-1 et les deux questions qui dimensionnent une stratégie de backup ;
- distinguer un backup complet, différentiel et incrémental, un instantané et une restauration à un instant donné ;
- décrire les cinq étapes d'un backup automatique et choisir l'outil qui correspond à votre stack et à votre hébergeur ;
- vérifier qu'un backup se restaure, et savoir combien de temps cela prend.
1. Ce qui arrive aux données
Le 31 janvier 2017, tard le soir, un ingénieur de GitLab veut vider le dossier de données d'un serveur de base de données secondaire. Il se croit sur le serveur secondaire, il est sur la production. Quand il s'en rend compte et arrête la commande, environ 300 Go de la base ont disparu.
L'équipe se tourne alors vers ses sauvegardes. Sur le papier, GitLab en avait plusieurs : un export chaque nuit, des copies de disque, une base répliquée. L'export nocturne échouait en silence, parce que l'outil pg_dump installé était en version 9.2 et la base en version 9.6. Les e-mails d'alerte étaient rejetés par le serveur de messagerie avant d'arriver. Les copies de disque n'étaient pas activées sur les serveurs de base de données, et la réplication était en panne. Le site a été sauvé par une copie du disque qu'un ingénieur avait faite à la main six heures plus tôt, pour alimenter un serveur de test. Selon le rapport publié par GitLab, les modifications faites entre 17 h 20 et minuit (UTC) ont été perdues, soit environ 5 000 projets, 5 000 commentaires et 700 nouveaux comptes. Le site est resté à l'arrêt 18 heures.
Les données ne se perdent pas seulement quand un disque tombe en panne.
| Cause | Exemple | Ce qui vous sauve |
|---|---|---|
| Erreur humaine | Un DROP TABLE ou un migrate:fresh lancé sur la production |
Un backup de la veille |
| Bug dans le code | Une migration qui vide une colonne, un UPDATE sans WHERE |
Un backup d'avant le déploiement |
| Panne ou sinistre | En mars 2021, un centre de données d'OVH brûle à Strasbourg | Une copie dans un autre lieu |
| Règle de l'hébergeur | La base gratuite de Render devient inaccessible après 30 jours, puis elle est supprimée | Une copie chez vous |
| Piratage | Un rançongiciel (ransomware) chiffre le serveur et tout ce qu'il peut atteindre, puis réclame une rançon | Une copie que le serveur ne peut pas effacer |
Lors de l'incendie d'OVH, des clients avaient bien des sauvegardes, mais sur le même site que leurs serveurs.
Attention
Trois choses ressemblent à un backup et n'en sont pas. Une base répliquée recopie chaque écriture sur un second serveur, y compris le DROP TABLE. Des disques en RAID, qui écrivent chaque donnée sur deux disques, protègent d'une panne de disque, pas d'une mauvaise commande. Un dossier synchronisé propage la suppression en quelques secondes. Un backup est une copie figée à une date, que l'application ne peut plus modifier.
2. Quoi sauvegarder
Une application web en production, c'est quatre choses. Chacune a sa propre copie de sécurité.
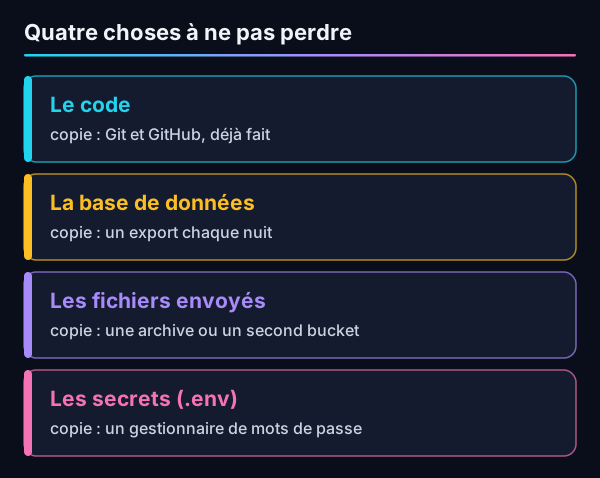
| Élément | Où il vit | Sa sauvegarde |
|---|---|---|
| Le code | Votre dépôt Git | GitHub et le clone de chaque membre du groupe. C'est déjà fait. |
| La base de données | PostgreSQL ou MySQL, sur le serveur ou chez un fournisseur | Un export : un fichier qui contient ce qu'il faut pour recréer les tables et leurs lignes. En anglais, un dump. |
| Les fichiers envoyés | Avatars, pièces jointes, PDF générés, sur le disque du serveur ou dans un stockage d'objets | Une archive du dossier, ou une copie dans un second bucket. Un bucket est un dossier dans un stockage d'objets comme Cloudflare R2 ou Amazon S3. |
| Les secrets | Le .env de production, les clés d'API |
Un gestionnaire de mots de passe partagé par le groupe. Jamais dans Git. |
Le reste se reconstruit et ne se sauvegarde pas : vendor/, node_modules/, le cache, les fichiers compilés, les logs. Un composer install ou un npm ci les recrée à partir du dépôt.
La base et les fichiers vont ensemble. Si la table messages contient le chemin uploads/photo-42.jpg et que le fichier a disparu, la restauration de la base seule donne une application pleine d'images cassées.
3. Les règles d'une bonne stratégie
La règle 3-2-1
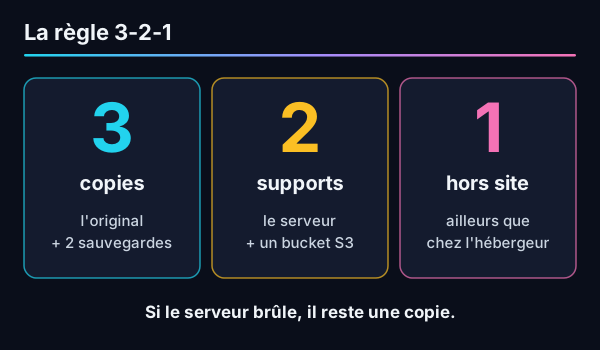
La règle tient en trois chiffres. Trois copies des données : l'original et deux sauvegardes. Deux supports différents, par exemple le disque du serveur et un stockage d'objets. Une copie hors site, c'est-à-dire ailleurs que chez l'hébergeur de l'application.
Pour votre projet, cela donne : la base en production, un export gardé sur le serveur pour restaurer vite, et le même export envoyé dans un bucket chez un autre fournisseur. Cloudflare R2, Backblaze B2 et les autres stockages d'objets proposent tous une API compatible avec celle d'Amazon S3. Un outil qui sait écrire dans « un bucket S3 » sait donc écrire chez n'importe lequel d'entre eux.
Deux questions pour régler la fréquence
Un backup est fait à 2 h 30, un incident survient à 14 h : tout ce qui a été écrit entre les deux est perdu. Avec un backup par nuit, cette perte peut atteindre 24 heures, si l'incident tombe juste avant le backup suivant. La perte maximale que vous acceptez s'appelle le RPO, pour Recovery Point Objective : l'objectif de point de reprise, c'est-à-dire le moment le plus ancien auquel vous acceptez de revenir. Un backup par nuit donne un RPO de 24 heures, un backup par heure un RPO d'une heure.
Entre l'incident et le retour en ligne, le site est à l'arrêt. L'arrêt maximal que vous acceptez s'appelle le RTO, pour Recovery Time Objective : l'objectif de délai de reprise. La durée réelle dépend de la taille du backup, de l'endroit où il se trouve, et surtout du fait que quelqu'un ait déjà fait la restauration une fois.
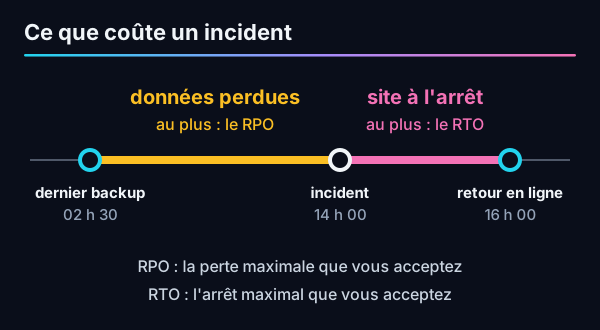
Pour un chat étudiant, perdre une journée de messages est acceptable : un backup par nuit suffit. Pour une boutique en ligne, perdre une journée de commandes ne l'est pas. Ces deux chiffres se décident avec le client, et ils fixent le prix de la solution.
Trois réglages de plus
- La rétention est la durée pendant laquelle vous gardez les anciens backups. Un bug qui abîme les données peut passer inaperçu une semaine. Si vous ne gardez que le backup d'hier, il contient déjà les données abîmées. Un réglage courant : 7 backups quotidiens, 4 hebdomadaires, 6 mensuels.
- La confidentialité. Un export contient les adresses e-mail, les mots de passe hachés et les messages privés de vos utilisateurs. Le bucket reste privé, et l'export n'entre jamais dans Git ni dans un dossier public du serveur. La plupart des outils savent aussi chiffrer le backup avec un mot de passe. Rangez ce mot de passe dans le gestionnaire du groupe : sans lui, le backup est illisible.
- L'alerte. Chez GitLab, l'export échouait en silence. Un backup automatique doit prévenir quelqu'un quand il échoue, et vous devez vérifier de temps en temps que le fichier du jour existe et ne pèse pas 0 octet.
4. Complet, différentiel, incrémental
Copier toute la base chaque nuit est simple, mais la copie grossit avec la base. Trois méthodes existent, qui diffèrent par ce qu'elles copient chaque jour.
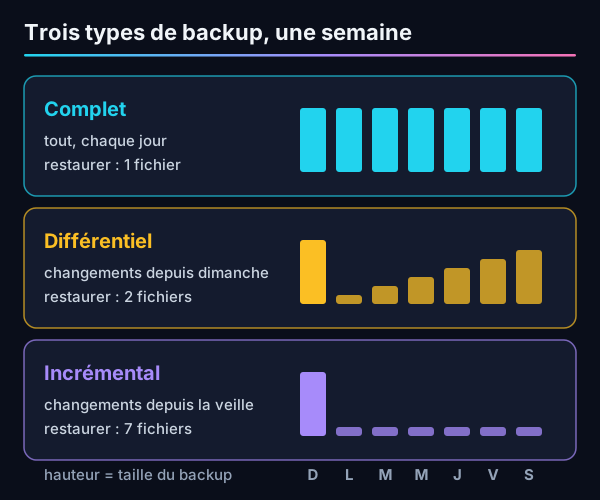
Prenez une application de 1 Go de données, dont 50 Mo changent chaque jour, avec un backup complet le dimanche.
- Le backup complet copie tout, chaque jour. Chaque fichier se suffit à lui-même.
- Le backup différentiel copie ce qui a changé depuis le dernier backup complet. Le lundi, 50 Mo. Le mardi, 100 Mo. Le samedi, 300 Mo. Pour restaurer, il faut deux fichiers : le complet du dimanche et le différentiel du jour voulu.
- Le backup incrémental copie ce qui a changé depuis le dernier backup, quel qu'il soit. 50 Mo chaque jour. Pour restaurer le samedi, il faut le complet du dimanche et les six incrémentaux, dans l'ordre. Si l'un d'eux est abîmé, tous les suivants sont inutilisables.
| Complet | Différentiel | Incrémental | |
|---|---|---|---|
| Place sur une semaine | 7 Go | environ 2 Go | 1,3 Go |
| Durée du backup | Longue | Moyenne, croît dans la semaine | Courte |
| Restauration | La plus simple | Simple | La plus longue et la plus fragile |
Plus le backup est léger à faire, plus la restauration est lourde. Dans la pratique, on combine : un complet par semaine, puis des incrémentaux ou des différentiels entre deux.
restic et borg, deux outils libres de sauvegarde de fichiers, vont plus loin. Ils découpent les données en blocs et n'envoient que les blocs nouveaux ou modifiés. Chaque backup est incrémental à l'envoi, et se restaure comme un complet.
Deux autres mots reviennent dans les documentations des hébergeurs :
- Un instantané (snapshot) est une photo d'un disque entier à un moment donné, prise par l'hébergeur. Il se restaure vite, mais il reste chez le même hébergeur, souvent sur la même infrastructure.
- La restauration à un instant donné (point-in-time recovery, PITR) pousse l'incrémental au bout. La base enregistre en continu le journal de toutes ses écritures. Vous pouvez la remettre dans l'état de 13 h 59, une minute avant le
DROP TABLE. La perte se compte en secondes.
Pour une base de projet étudiant, qui pèse quelques dizaines de mégaoctets, un export complet chaque nuit suffit. L'incrémental devient utile pour les fichiers envoyés, qui grossissent vite, et le PITR quand chaque minute de données compte.
Ce que coûte la copie hors site
Un stockage d'objets facture la place occupée, au gigaoctet par mois, et parfois la sortie, c'est-à-dire les données que vous téléchargez depuis le bucket. Voici les tarifs d'octobre 2026.
| Service | Gratuit | Ensuite | Sortie des données |
|---|---|---|---|
| Cloudflare R2 | 10 Go | 0,015 $ par Go et par mois | Gratuite |
| Backblaze B2 | 10 Go | 0,007 $ par Go et par mois | Gratuite jusqu'à trois fois le volume stocké |
| Amazon S3 (Irlande) | Rien de permanent | 0,023 $ par Go et par mois | 100 Go gratuits par mois, puis 0,09 $ par Go |
| Hetzner Object Storage | Rien | Forfait de 6,49 € par mois pour 1 To | 1 To inclus |
| Hostkey S3 | Rien | Forfait de 4 € par mois pour 250 Go, puis 0,017 € par Go | 1 To inclus |
La sortie compte le jour de la restauration. Télécharger 500 Go de backups depuis Amazon S3 coûte 36 $. Depuis R2, rien.
Faites le calcul pour votre projet. Un export de 50 Mo par nuit, gardé 30 jours, occupe 1,5 Go. Ajoutez 2 Go de fichiers envoyés. Le tout tient dans les 10 Go gratuits de R2 ou de B2 : votre copie hors site coûte 0 €.
Le calcul change avec la taille. Pour une base de 50 Go, trente exports complets occupent 1,5 To, soit une vingtaine de dollars par mois chez R2. À cette taille, les backups incrémentaux deviennent rentables, ou un stockage dit « froid », moins cher et prévu pour des archives rarement relues.
Cloudflare demande d'enregistrer un moyen de paiement pour activer R2, même si vous restez dans la partie gratuite. Amazon demande une carte bancaire dès la création du compte. Les sources de tous ces prix sont listées à la fin du chapitre.
5. Automatiser le backup
Un backup lancé à la main est oublié au bout de deux semaines. Quel que soit l'outil, un backup automatique fait toujours les cinq mêmes choses, chaque nuit.
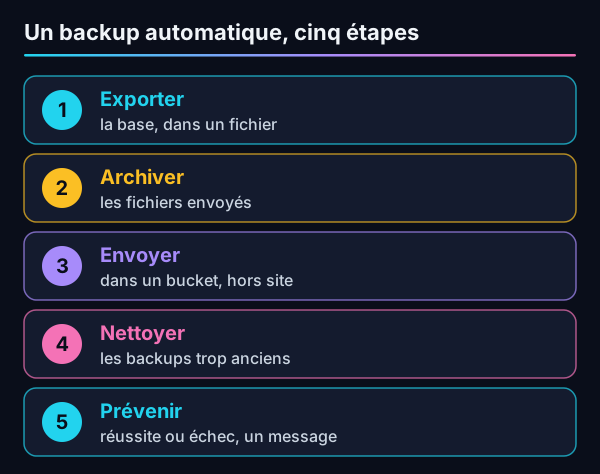
| Étape | Ce qui se passe | Outils courants |
|---|---|---|
| 1. Exporter | La base est lue pendant qu'elle tourne et écrite dans un fichier | pg_dump pour PostgreSQL, mysqldump pour MySQL |
| 2. Archiver | Le dossier des fichiers envoyés devient une archive compressée | tar, ou restic quand le dossier grossit |
| 3. Envoyer | L'export et l'archive partent dans un bucket, hors du serveur | rclone, aws s3, ou l'outil intégré de votre panneau |
| 4. Nettoyer | Les backups plus vieux que la rétention sont supprimés | Une règle du bucket, ou une commande du script |
| 5. Prévenir | Quelqu'un reçoit un message : réussite ou échec | Un e-mail, un webhook Discord, Healthchecks.io |
Trois pièges reviennent, quel que soit l'outil.
- La version de l'outil d'export.
pg_dumpdoit avoir la même version majeure que la base, ou une version plus récente. Sinon il s'arrête avec une erreur. C'est la panne de GitLab. - Synchroniser n'est pas copier. Une commande comme
rclone syncrend la destination identique à la source : un fichier supprimé par erreur disparaît aussi de la copie. Pour un backup, on copie (rclone copy), on ne synchronise pas. - Les fichiers déjà dans un bucket ne sont pas à l'abri pour autant. Une suppression dans l'application supprime l'objet. Activez le versionnement du bucket, qui garde les anciennes versions des objets supprimés ou écrasés, ou copiez-le chaque nuit vers un second.
Être prévenu
C'est l'étape qu'on oublie, et celle qui a manqué à GitLab. Un backup qui échoue en silence est pire qu'une absence de backup : vous croyez être protégés.
Deux mécanismes se complètent. Le script envoie lui-même un message à la fin, par e-mail ou par webhook, une adresse fournie par Discord, Slack ou Teams qui affiche dans un salon le texte qu'on lui envoie. Vous voyez chaque matin « Backup : OK », ou « Backup : ÉCHEC ». Mais si le serveur est éteint, aucun message ne part. Un service comme Healthchecks.io fait l'inverse : il attend un signal chaque nuit, et c'est lui qui vous écrit quand le signal manque.
Un exemple de script
Voici à quoi ressemblent les cinq étapes sur un VPS, pour une base PostgreSQL, des fichiers sur le disque et un bucket chez Cloudflare R2.
Attention
Ce script est un exemple, pas une solution à copier. Chaque chemin, chaque nom et chaque outil dépend de votre installation. Adaptez-le, lancez-le à la main, puis restaurez son résultat avant de lui faire confiance.
#!/usr/bin/env bash
# /srv/chat/backup.sh : exemple à adapter
set -euo pipefail              # le script s'arrête à la première erreur

source /srv/chat/backup.env    # définit DATABASE_URL et DISCORD_WEBHOOK_URL
STAMP=$(date +%F-%H%M)         # 2026-10-05-0230
DIR=/var/backups/chat
mkdir -p "$DIR"

# Envoie un message dans un salon Discord
notify() {
  curl -fsS -H "Content-Type: application/json" -d "{\"content\": \"$1\"}" "$DISCORD_WEBHOOK_URL" > /dev/null
}
trap 'notify "Backup du chat : ÉCHEC"' ERR   # appelé si une commande échoue

# 1. Exporter la base
pg_dump --format=custom --file="$DIR/db-$STAMP.dump" "$DATABASE_URL"

# 2. Archiver les fichiers envoyés par les utilisateurs
tar -czf "$DIR/uploads-$STAMP.tar.gz" -C /srv/chat/storage uploads

# 3. Envoyer la copie hors site
rclone copy "$DIR" r2:chat-backups

# 4. Nettoyer : 7 jours sur le serveur, 30 jours dans le bucket
find "$DIR" -type f -mtime +6 -delete
rclone delete r2:chat-backups --min-age 30d

# 5. Prévenir
notify "Backup du chat : OK ($STAMP)"
Sur un serveur Linux, c'est cron, le planificateur de tâches du système, qui lance ce script chaque nuit. Une ligne suffit, ajoutée avec sudo crontab -e :
30 2 * * * /srv/chat/backup.sh >> /var/log/backup-chat.log 2>&1
Les cinq champs se lisent : minute, heure, jour du mois, mois, jour de la semaine. Vous avez déjà rencontré cette syntaxe dans les workflows GitHub Actions.
6. Quel outil pour votre stack
Écrire son script est rarement nécessaire. Selon votre hébergement, les cinq étapes sont lancées par un outil différent, depuis un endroit différent.
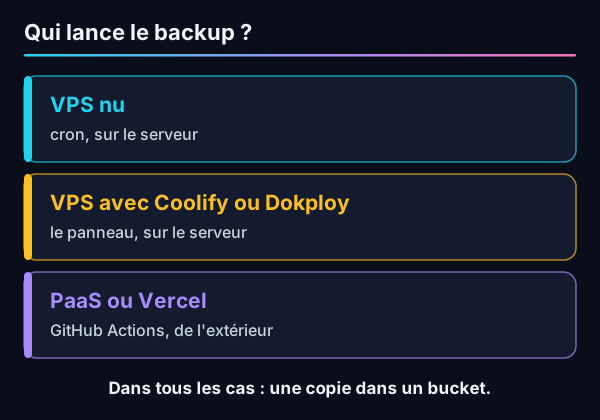
Pour chaque outil, cette partie dit ce qu'il fait, ce qu'il ne fait pas, et où lire la suite. Les réglages exacts changent d'une version à l'autre : suivez la documentation officielle, pas un tutoriel de 2022.
Les backups de votre fournisseur de VPS
La plupart des hébergeurs de VPS vendent une sauvegarde du disque entier. Chez OVHcloud, chaque VPS reçoit un backup quotidien, gardé 24 heures, sans supplément. L'option Premium garde 7 jours et coûte à partir de 0,30 € HT par mois, selon la taille du disque. Un instantané manuel, utile avant une mise à jour risquée, est au même prix.
C'est le moyen le plus rapide de remettre un serveur entier en route. Mais OVHcloud précise que ces copies sont stockées dans le même centre de données que le VPS. Elles comptent comme une copie, pas comme la copie hors site.
Coolify et Dokploy
Si vous déployez avec un panneau, le backup de la base se règle dans l'interface, sans script.
Dans Coolify, l'onglet Backups d'une base de données propose une fréquence et une rétention. Coolify lance l'outil d'export dans le conteneur et garde le fichier sur le serveur. Pour la copie hors site, vous déclarez un stockage S3 dans les réglages, puis vous l'activez dans la planification. La restauration se lance depuis Configuration > Import Backup.
Pour les fichiers, Coolify archive les volumes d'une application vers le même stockage S3. Un volume est le dossier du serveur qu'un conteneur utilise pour garder ses fichiers d'un déploiement à l'autre. Coolify crée ces archives mais n'a pas de bouton pour les restaurer : il faut extraire l'archive à la main.
Dokploy propose la même chose : un onglet Backups sur chaque base, avec une destination S3, une fréquence et un bouton Test, et des Volume Backups pour les fichiers.
Documentation : backups Coolify, backups Dokploy.
Laravel : spatie/laravel-backup
Le paquet spatie/laravel-backup est la référence du monde Laravel. Il ajoute trois commandes Artisan, que le planificateur de Laravel lance chaque nuit.
| Commande | Ce qu'elle fait |
|---|---|
backup:run |
Exporte la base, archive les dossiers choisis, envoie un zip vers un disque Laravel, par exemple un bucket S3 |
backup:clean |
Applique la rétention : supprime les zips trop anciens |
backup:monitor |
Vérifie qu'un backup récent existe, et envoie un e-mail ou un message Slack ou Discord dans le cas contraire |
Ce qu'il faut savoir avant de l'installer. Le paquet appelle pg_dump ou mysqldump, qui doit donc être installé là où tourne l'application. Le planificateur de Laravel doit être lancé par un cron ou par une tâche planifiée du panneau. Les alertes ne partent que si vous indiquez votre adresse et le disque à surveiller dans la configuration. Et le paquet ne restaure pas : vous téléchargez le zip, vous le décompressez, et vous rechargez l'export.
Documentation : spatie.be/docs/laravel-backup.
Django : django-dbbackup
L'équivalent pour Django s'appelle django-dbbackup. Il s'appuie sur le système de stockage de Django, donc sur django-storages pour écrire dans un bucket S3.
| Commande | Ce qu'elle fait |
|---|---|
dbbackup |
Exporte la base vers le stockage configuré, avec compression et chiffrement en option |
mediabackup |
Archive le dossier des fichiers envoyés |
dbrestore et mediarestore |
Rechargent le dernier backup de la base et des fichiers |
Django n'a pas de planificateur : les deux premières commandes se lancent depuis un cron du serveur ou une tâche planifiée de votre panneau. Contrairement au paquet Laravel, celui-ci restaure.
Documentation : archmonger.github.io/django-dbbackup.
Node.js
Des paquets existent sur npm, mais aucun n'a la place de laravel-backup dans le monde Laravel. Ce sont de petits projets, peu mis à jour, qui exportent la base puis envoient le fichier dans un bucket. Laravel et Django sont des frameworks complets, avec un planificateur, un système de fichiers et des notifications sur lesquels un paquet de backup peut s'appuyer. Une application Express ou Fastify n'a rien de tout cela en commun avec sa voisine.
Les équipes Node sortent donc le backup de l'application. Elles utilisent le backup du panneau, un script lancé par cron, ou un workflow GitHub Actions. Si vous utilisez Prisma ou Drizzle, rien ne change : ces bibliothèques décrivent le schéma de la base, elles n'exportent pas les données.
Les fichiers : restic et rclone
Deux outils libres reviennent dans toutes les stacks. rclone copie des fichiers vers plus de cinquante services de stockage : c'est lui qui envoie une archive dans un bucket, ou qui copie un bucket vers un autre. restic fait des backups incrémentaux et chiffrés d'un dossier, directement dans un bucket. Il devient utile quand les fichiers envoyés dépassent quelques gigaoctets.
Documentation : rclone.org, restic.net.
7. Sur une plateforme managée
Sur un PaaS ou en serverless, vous n'avez ni serveur ni cron. La plateforme fait une partie du travail, et cette partie dépend du plan que vous payez. Voici l'état des lieux en octobre 2026.
- Render. Sur une base payante, à partir de 6 $ par mois : restauration à un instant donné sur 3 ou 7 jours selon le plan du compte, et export téléchargeable gardé 7 jours. Sur la base gratuite : aucun backup.
- Railway. Backups planifiés des volumes : quotidiens gardés 6 jours, hebdomadaires 27 jours, mensuels 89 jours. Ils demandent le plan Pro, à 20 $ par mois. Chaque backup est facturé pour la place qu'il occupe, à 0,15 $ par Go et par mois.
- Fly.io. Instantané quotidien de chaque volume, gardé 5 jours, réglable de 1 à 60. Les 10 premiers Go sont gratuits, puis 0,08 $ par Go et par mois. Le Postgres managé garde ses backups 10 jours et démarre à 38 $ par mois.
- Neon. Restauration à un instant donné sur 6 heures avec le plan gratuit. Sur les plans payants, 1 jour par défaut, réglable jusqu'à 7 ou 30 jours, à 0,20 $ par Go d'historique et par mois.
- Supabase. Plan gratuit : aucun backup. Plan Pro, à 25 $ par mois : un backup par jour, gardé 7 jours. La restauration à un instant donné est une option à 100 $ par mois pour 7 jours. Les fichiers du Storage ne sont jamais inclus.
- Vercel. Vercel n'héberge pas de base : elle vient de Neon, de Supabase ou d'un autre fournisseur. Vercel Blob coûte à partir de 0,023 $ par Go et par mois, et n'a pas de backup intégré.
Le chapitre sur l'hébergement comptait les sauvegardes parmi ce que gère un PaaS. C'est vrai sur les plans payants, et chez lui seulement. Toutes les copies sont chez le même fournisseur, attachées au même compte : la règle 3-2-1 n'est pas remplie. Un compte suspendu, une carte refusée ou un projet supprimé par erreur, et les backups partent avec la base. Sur les plans gratuits de Render et de Supabase, aucun backup n'existe.
La copie hors site avec GitHub Actions
Vous n'avez pas de serveur pour lancer un cron, mais vous avez un dépôt GitHub. Un workflow peut se déclencher à heure fixe, avec le déclencheur schedule et la même syntaxe que cron. Il fait alors les étapes de la partie 5 depuis une machine de GitHub : il exporte la base avec pg_dump, puis dépose le fichier dans un bucket.
Ce workflow n'utilise pas SSH : il n'y a pas de serveur sur lequel se connecter. La machine de GitHub parle directement à deux services, chacun avec son secret, rangé dans les secrets du dépôt comme au chapitre CI/CD.
- À la base de données, par le réseau, comme le fait votre application. Le secret est l'adresse de connexion de la base, qui contient l'hôte, l'utilisateur et le mot de passe.
- Au bucket, en HTTPS, avec une clé d'API. Vous créez cette clé dans le tableau de bord du stockage, et vous pouvez la limiter à un seul bucket.
Si l'export échoue, le workflow s'arrête et GitHub vous envoie un e-mail : l'alerte est comprise. La rétention se règle du côté du bucket, avec une règle de cycle de vie qui supprime les objets trop anciens.
Deux limites. Sur un VPS, la base n'écoute en général que sur le serveur lui-même, et le workflow ne peut pas l'atteindre : le backup tourne alors sur le serveur. Et dans un dépôt public, GitHub désactive les workflows planifiés après 60 jours sans activité. Sur un projet terminé mais encore en ligne, le backup s'arrête sans prévenir.
Documentation : le déclencheur schedule de GitHub Actions.
Les fichiers sur une plateforme managée
Sur Render, Railway ou Fly.io, les fichiers écrits sur un volume sont couverts par les backups ou les instantanés décrits plus haut. Sur Vercel, ils sont dans Vercel Blob ou dans un autre stockage d'objets : activez le versionnement du bucket, ou copiez-le régulièrement vers un second. La documentation de Vercel décrit cette copie périodique.
8. Restaurer : la preuve que le backup existe
Tant que vous n'avez pas restauré un backup, vous ne savez pas s'il fonctionne. Le fichier peut être vide, tronqué, chiffré avec un mot de passe perdu, ou exporté avec une version de l'outil que votre PC ne sait pas lire.
L'essai se fait sur votre PC, sans risque pour la production.
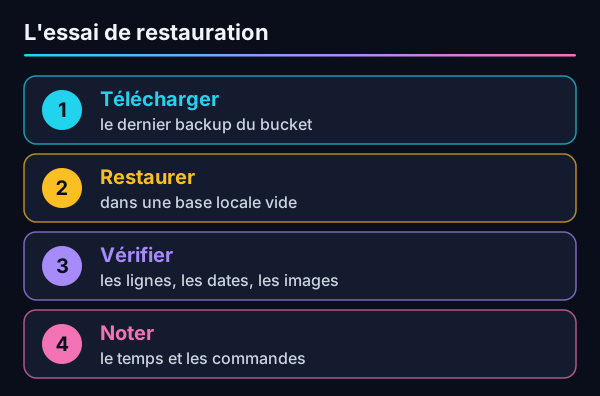
- Télécharger le dernier backup depuis le bucket : l'export de la base et l'archive des fichiers.
- Restaurer l'export dans une base locale vide, et extraire l'archive dans votre projet local.
- Vérifier. Le nombre de lignes doit correspondre à la production, et la date du dernier message à l'heure du backup. Pointez votre application locale sur cette base et ouvrez une conversation : les images s'affichent-elles ?
- Noter le temps total et chaque commande tapée, dans un fichier
RESTORE.mdà la racine du dépôt.
Le temps total, du téléchargement à l'application qui tourne, est la durée réelle de votre arrêt, à comparer à votre RTO. Les commandes notées servent le jour de l'incident, quand personne n'a envie de chercher la bonne option.
Pour un export PostgreSQL fait avec pg_dump, les étapes 2 et 3 ressemblent à ceci. Les noms sont à adapter à votre projet.
createdb chat_restore
pg_restore --no-owner --dbname=chat_restore db-2026-10-05-0230.dump
psql chat_restore -c "SELECT count(*), max(created_at) FROM messages;"
Un essai réussi une fois ne prouve rien pour la suite. Entre-temps, la base change de version, un dossier de fichiers s'ajoute, une clé d'API expire, et personne ne remarque que le backup ne se restaure plus. Refaites l'essai à date fixe, tous les trois mois par exemple, avec un rappel dans l'agenda du groupe. Refaites-le aussi après chaque changement important : nouvelle version de la base, nouvel hébergeur, nouveau dossier de fichiers.
9. Par où commencer
| Votre hébergement | La base | Les fichiers |
|---|---|---|
| VPS avec Coolify ou Dokploy | Backup planifié du panneau, ou paquet de votre framework, vers un bucket S3 | Backup des volumes du panneau, vers le même bucket |
| VPS nu | Un script et un cron, ou le paquet de votre framework | Le même script, ou restic |
| PaaS (Render, Railway, Fly.io) | Les backups de la plateforme s'ils existent sur votre plan, plus un workflow GitHub Actions pour la copie hors site | Les backups de volume de la plateforme |
| Vercel et base managée | Un workflow GitHub Actions | Versionnement du bucket ou copie vers un second |
Dans tous les cas, la liste est la même :
- un backup automatique chaque nuit ;
- une copie dans un bucket qui n'est pas chez votre hébergeur ;
- une rétention d'au moins sept jours ;
- un message en cas d'échec ;
- une restauration essayée, notée, puis refaite tous les trois mois.
Pour votre projet, décrivez une stratégie de backup dans votre rapport et mettez-la en place : elle vous rapporte des points en fonctionnalités supplémentaires. La description dit ce qui est sauvegardé, à quelle fréquence, où vont les copies, combien de temps elles sont gardées, et combien de temps a pris votre essai de restauration.
En résumé
- Un backup est une copie figée, que l'application ne peut plus modifier. La réplication, le RAID et la synchronisation n'en sont pas.
- Quatre choses à protéger : le code est dans Git, les secrets dans un gestionnaire de mots de passe. Il reste la base et les fichiers envoyés, qui se sauvegardent ensemble.
- La règle 3-2-1 demande trois copies, deux supports et une copie hors site. Les backups d'un hébergeur restent chez lui : ajoutez un bucket ailleurs.
- Un backup automatique fait cinq choses : exporter, archiver, envoyer, nettoyer, prévenir. L'outil change selon la stack, les étapes non.
- Restaurez un backup, et recommencez tous les trois mois. Faites l'essai sur votre PC, chronométrez-le et écrivez la procédure.
Pour aller plus loin
- Le récit de l'incident GitLab du 31 janvier 2017 : https://about.gitlab.com/blog/postmortem-of-database-outage-of-january-31/
- PostgreSQL,
pg_dumpetpg_restore: https://www.postgresql.org/docs/current/backup-dump.html - MySQL,
mysqldump: https://dev.mysql.com/doc/refman/8.4/en/mysqldump.html - Coolify : https://coolify.io/docs/databases/backups · Dokploy : https://docs.dokploy.com/docs/core/databases/backups
- spatie/laravel-backup : https://spatie.be/docs/laravel-backup · django-dbbackup : https://archmonger.github.io/django-dbbackup/
- rclone : https://rclone.org · restic : https://restic.net · Healthchecks.io : https://healthchecks.io
- Webhooks Discord : https://support.discord.com/hc/fr/articles/228383668
- Vercel Blob, exemples de copie de sauvegarde : https://vercel.com/docs/vercel-blob/examples
Sources des prix et des durées
Pages officielles consultées le 4 octobre 2026. Les tarifs changent souvent : vérifiez-les avant de choisir.
- Stockage d'objets : Cloudflare R2 · Backblaze B2 · Amazon S3 · Hetzner Object Storage · Hostkey S3
- VPS : options de sauvegarde OVHcloud
- Render : backups PostgreSQL · tarifs
- Railway : backups de volumes · plans
- Fly.io : instantanés de volumes · tarifs
- Neon : fenêtre d'historique · tarifs
- Supabase : backups · tarifs
- Vercel Blob : tarifs